Một GPU có thể phục vụ tốt cho giai đoạn Pilot hoặc một mô hình AI cỡ nhỏ. Nhưng khi doanh nghiệp chuyển sang mô hình lớn hơn (để trả lời chính xác và "hiểu" ngữ cảnh phức tạp hơn), hoặc khi số nhân viên dùng trợ lý AI cùng lúc tăng lên, một GPU duy nhất sẽ chạm giới hạn theo hai cách khác nhau: hết bộ nhớ VRAM để nạp mô hình, hoặc hết khả năng xử lý song song để phục vụ nhiều yêu cầu cùng lúc. Kết hợp nhiều GPU là cách giải quyết cả hai giới hạn đó — nhưng cách kết hợp cần đúng với vấn đề đang gặp phải.
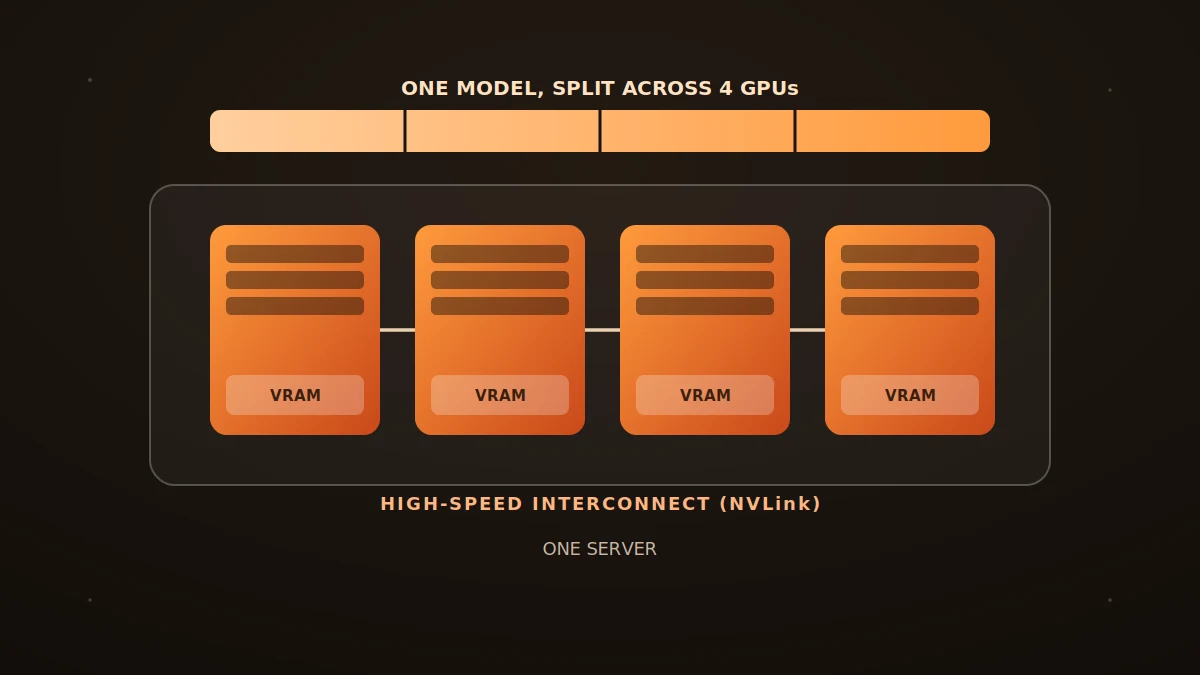
Khi mô hình AI quá lớn để nạp vừa vào bộ nhớ của một GPU, giải pháp là model parallelism (song song hoá mô hình): chia chính mô hình đó ra thành nhiều phần, mỗi GPU chỉ giữ và xử lý một phần. Các GPU sau đó phối hợp với nhau để cùng trả lời một câu hỏi duy nhất — GPU này xử lý xong một phần thì chuyển tiếp cho GPU kế tiếp. Cách này giúp chạy được những mô hình lớn hơn nhiều lần so với dung lượng của một GPU, nhưng đòi hỏi các GPU phải trao đổi dữ liệu với nhau liên tục trong suốt quá trình xử lý.
Khi vấn đề không phải là mô hình quá lớn mà là quá nhiều người dùng cùng lúc, giải pháp phù hợp hơn là data parallelism (song song hoá theo dữ liệu): chạy nhiều bản sao độc lập của cùng một mô hình (mỗi bản vừa đủ trong một GPU), mỗi GPU tự xử lý một nhóm yêu cầu riêng. Cách này không giúp chạy mô hình lớn hơn, nhưng tăng đáng kể số người dùng có thể được phục vụ đồng thời — gần như tuyến tính theo số GPU thêm vào.
Vì model parallelism cần các GPU trao đổi dữ liệu liên tục, tốc độ kết nối giữa chúng quan trọng không kém tốc độ của từng GPU. Trong một máy chủ, các GPU thường nối với nhau qua NVLink — đường truyền tốc độ rất cao, được thiết kế riêng cho việc này — nhanh hơn nhiều so với việc để các GPU nằm ở những máy chủ khác nhau và trao đổi qua mạng thông thường. Đây là lý do vì sao model parallelism hiệu quả nhất khi các GPU cùng nằm trong một máy chủ, còn việc mở rộng ra nhiều máy chủ lại phù hợp hơn với data parallelism, nơi các GPU không cần trao đổi dữ liệu với nhau theo thời gian thực.
DABO đánh giá đúng bài toán của từng doanh nghiệp trước khi đề xuất cấu hình GPU — dựa trên kích thước mô hình cần dùng và số người dùng dự kiến cùng lúc, thay vì mặc định cấu hình càng nhiều GPU càng tốt. Với doanh nghiệp cần một mô hình lớn nhưng ít người dùng cùng lúc, DABO ưu tiên model parallelism trong một máy chủ có NVLink; với doanh nghiệp cần phục vụ nhiều nhân viên nhưng mô hình vừa phải, DABO ưu tiên nhân bản theo data parallelism, kết hợp cùng kiến trúc lưu trữ SAN và replication đã đề cập ở các bài trước — để khách hàng có đúng số GPU cần thiết, không thừa không thiếu.